05.1 · Session与Run:怎样保存、执行和结束
用一段直播复盘划清Session与Run,具体说明会话存储、隔离、正常完成、停止和异常处理。
内容同步:2026年10月25日 · 文档版本 5
Session保存一整段对话;Run是其中一项请求从被受理,到完成、失败或取消的一次执行。
在Harness里,会话与执行管理接住用户消息,保存它属于谁、交给哪次执行、执行到哪一步,再由上下文层组织模型输入、工具层完成操作。
1. 一段直播复盘,怎样划分Session和Run?
假设你要分析昨晚直播的成交额。为方便阅读,下面按执行顺序编号为run-1、run-2、run-3。
- 新建“昨晚直播复盘”对话,得到
session-S1。发送“分析成交额下降原因”后,系统受理请求,创建run-1。 - 系统查成交额、查流量,多次调用模型。你中途补充“只看新品”,或回答“新品是本周上架的商品”,仍在推进
run-1。等待你回答时,这次执行还没有结束。 - 报告提交后,
run-1完成。你接着要求“展开讲讲流量因素”,创建run-2;后来又要求“分析库存风险”,创建run-3。它们仍属于S1,可以引用前面的报告。
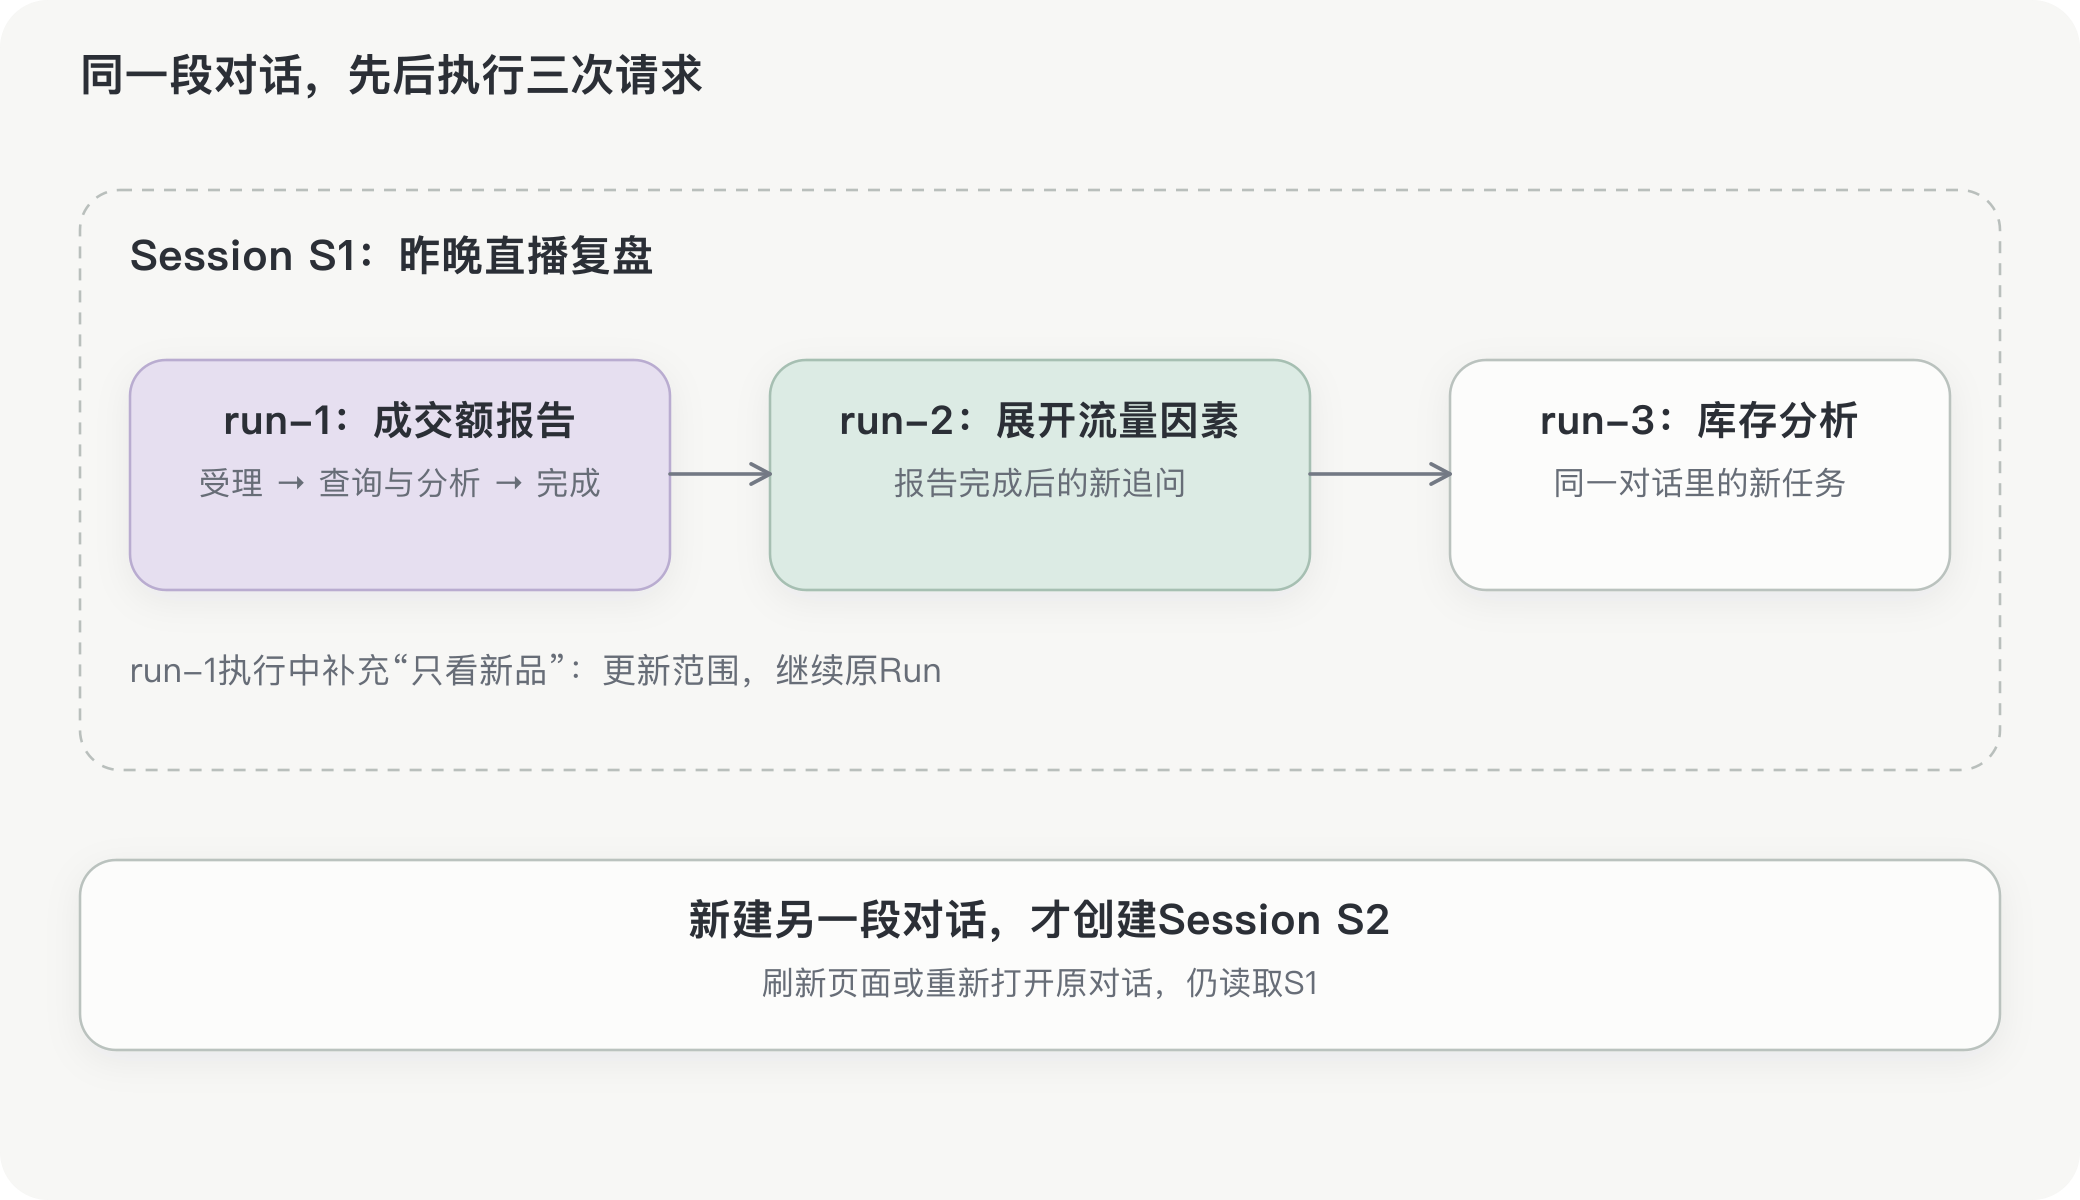
本例选择“执行中补充继续当前Run,结束后的新请求创建新Run”。其他产品可以采用不同规则,但必须明确告诉程序这条消息属于哪次执行,不能只看它排在聊天记录的最后。
Session的边界由新建对话确定。重新打开“昨晚直播复盘”仍读取S1,新建另一段对话才得到S2。Run内部可以有多次模型请求和工具往返;查询超时后在预算内重试,也不必创建新Run。
2. 这段对话具体存在哪里?
用文件时,一个Session一个目录,每次Run有自己的状态、操作记录和报告。 例如单机工具可以采用下面的教学路径:
/agent-data/accounts/user-1/sessions/
├── session-S1/
│   ├── session.json              # 标题、账户、归档状态
│   ├── messages.jsonl            # 按顺序追加消息
│   ├── summary.json              # 历史摘要及覆盖范围
│   └── runs/
│       ├── run-1/
│       │   ├── run.json          # completed、起止时间
│       │   ├── operations.jsonl  # 模型与工具操作记录
│       │   └── report.md         # 已交付的报告
│       ├── run-2/
│       │   └── run.json          # 引用run-1的报告
│       └── run-3/
│           └── run.json          # 库存分析的状态
└── session-S2/
    ├── session.json
    ├── messages.jsonl            # S2自己的消息
    └── runs/
用户补充“只看新品”,可以在S1的messages.jsonl里追加一行:
{"seq":2,"sessionId":"session-S1","runId":"run-1","role":"user","text":"只看本周上架的新品"}
重新打开S1时,读取messages.jsonl恢复对话,读取runs/run-1/run.json显示执行状态,读取report.md展示报告。历史可以完整保存;每轮交给模型的内容仍由Context选择,不必全部发送。
换成数据库,同一份数据可以对应这些记录:
| 表 | 示例记录 |
|---|---|
sessions | user-1 / session-S1 / 昨晚直播复盘 |
messages | user-1 / session-S1 / run-1 / seq=2 / 只看新品 |
runs | user-1 / session-S1 / run-1 / completed |
operations | user-1 / session-S1 / run-1 / op-1 / 查询成交额 / succeeded |
读取S1的消息时,查询范围写进程序:
SELECT seq, run_id, role, content
FROM messages
WHERE account_id = :accountId AND session_id = :sessionId
ORDER BY seq;
accountId来自已验证的用户身份,访问S1前还要检查会话权限。写入Run或操作时,也要检查其账户、Session和Run归属一致;不能查出用户全部消息,再让模型判断哪些属于S1。
文件还是数据库?
| 方案 | 适用方式与要处理的问题 |
|---|---|
| 分目录文件 | 本地小工具容易查看和备份;同一会话写入要串行或加锁,并处理日志写了一半、整份文件覆盖等情况 |
| SQLite | 数据保存在本机数据库文件中,可使用查询和事务;适合单机应用,写事务要短,不当成多机器共享文件使用 |
| PostgreSQL等服务端数据库 | 多用户服务集中存储,支持事务和条件更新;每次访问仍要限定归属、检查权限 |
防止串会话,还要让临时状态使用同样的范围。S1缓存可以用user-1:session-S1:run-1:report,S2不能共用一个叫report的键或一份全局消息数组。接入托管历史的外部服务时,本地Session也应映射到正确的远端对话。
分目录只是组织文件,不能代替权限检查。同账户的S1和S2也不默认共享私有历史;确需共用项目资料或长期记忆,再经过明确的共享入口读取。
3. 一次正常执行,怎样走到完成?
和传统异步报表服务一样,程序先受理、记录状态,再执行并保存报告。Agent增加了模型选择下一步的环节,任务身份和交付状态仍由程序管理。
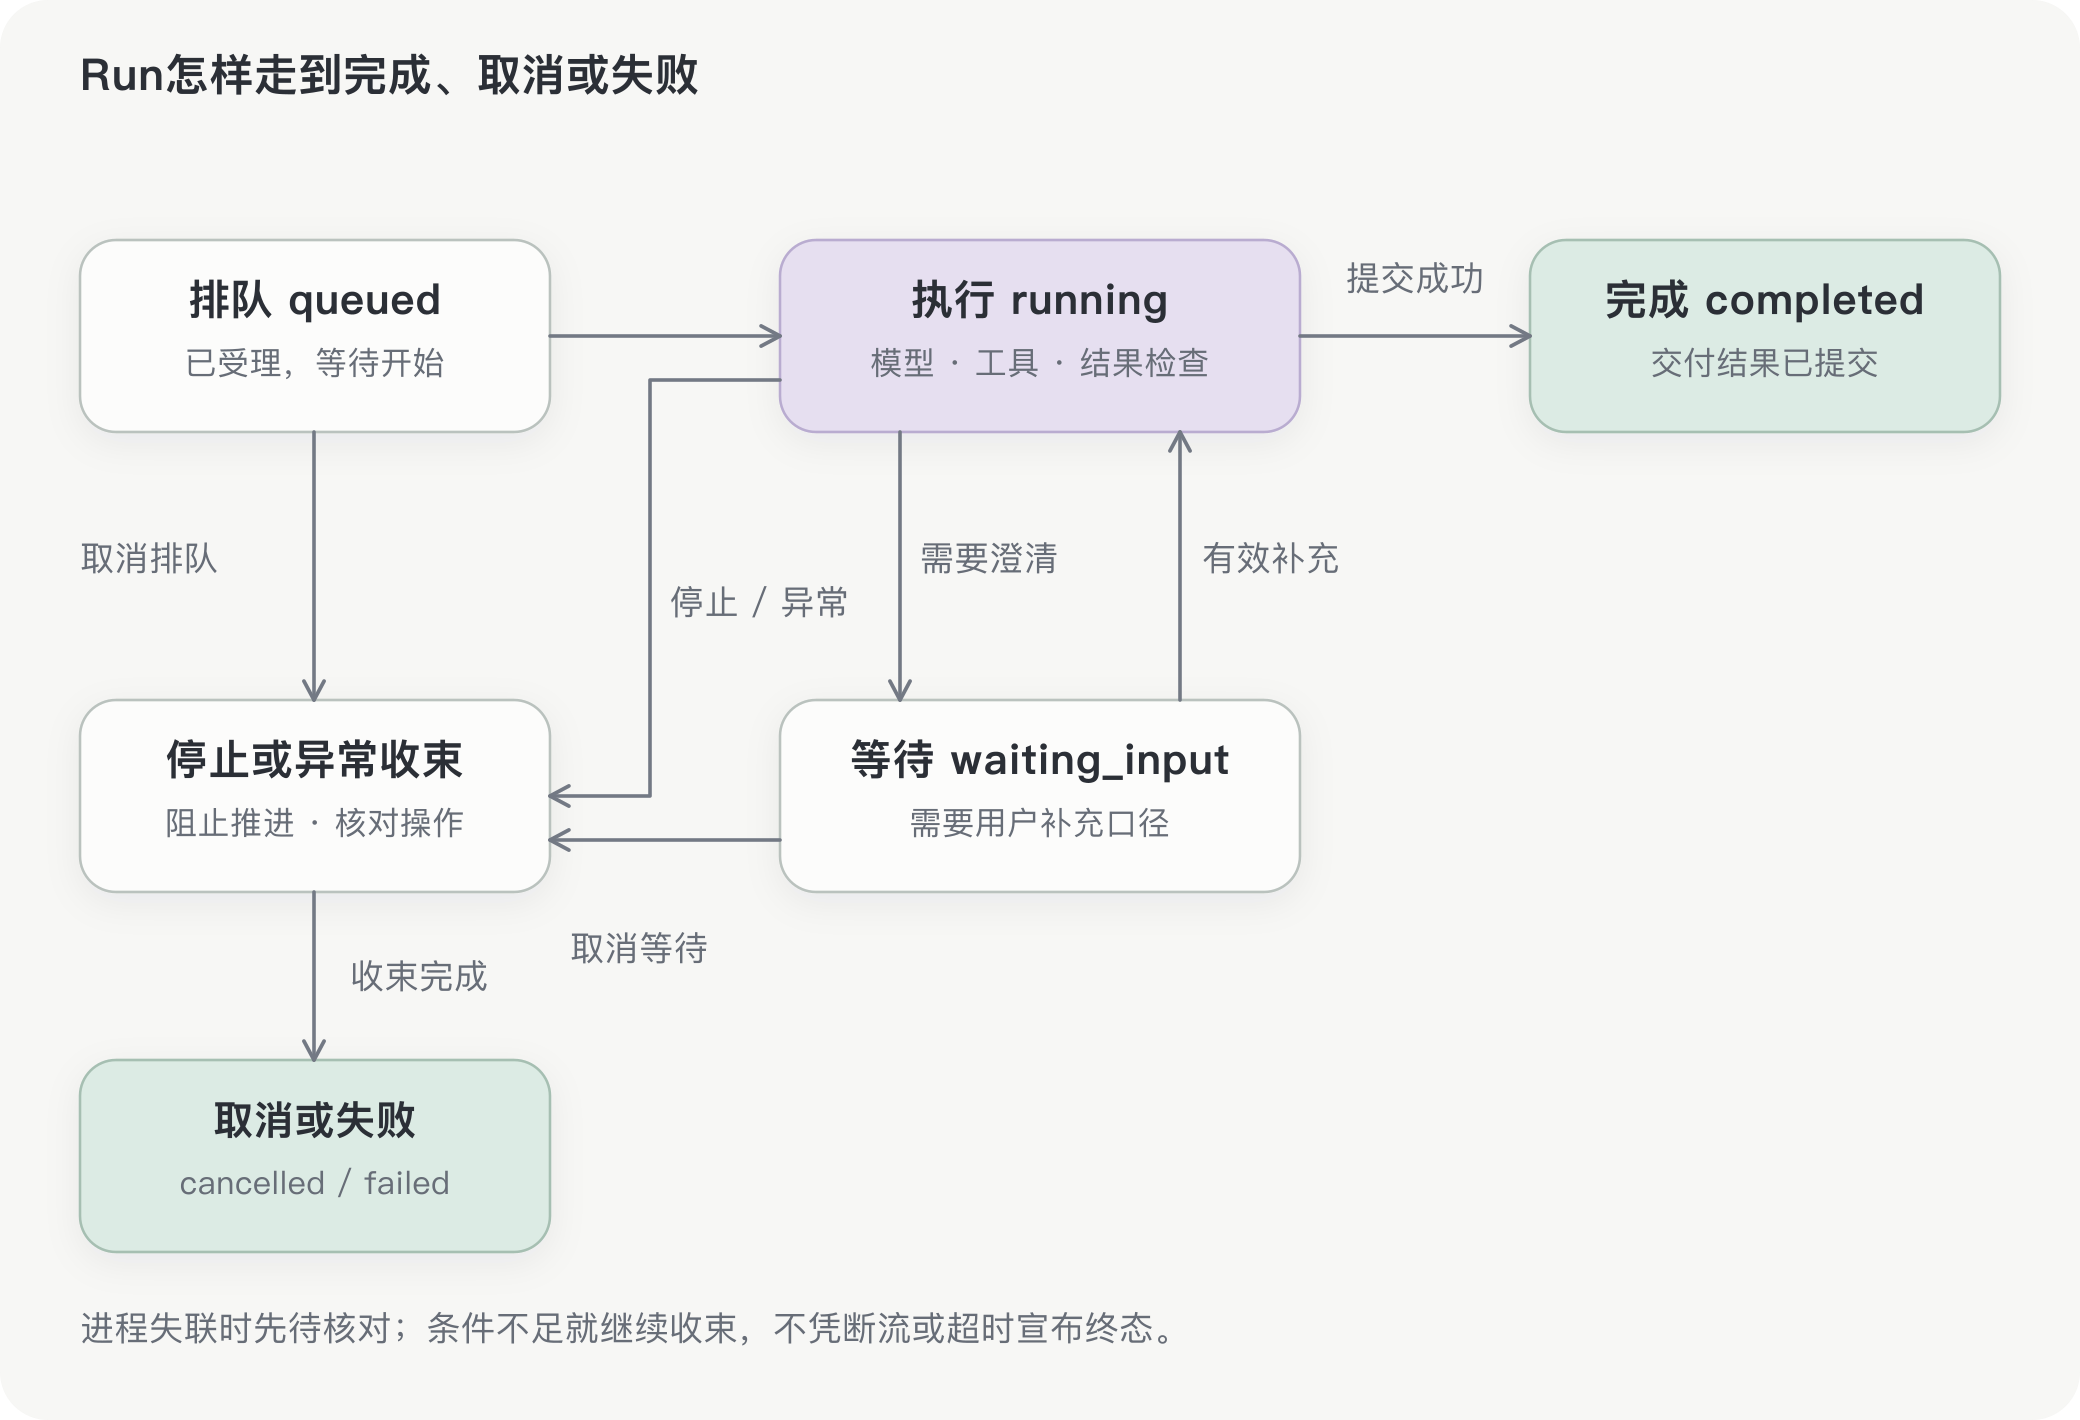
queued是已受理、待执行,running包括等待普通模型和工具响应,waiting_input表示需要用户补充信息。工具查询花几秒,不等于在等用户。
沿成交额分析走一遍:
- 保存S1的新消息和
run-1记录,再返回“已受理”。受理成功不代表分析成功。 - 发起模型或工具调用前,先登记操作标识、归属与待执行状态。外部导出等任务拿到远端任务ID后及时保存;来不及确认的操作保留未决记录,便于之后核对。
- 工具结果回来,保存实际结果,再决定继续查询、向用户澄清,还是生成报告。单次调用失败可在预算内重试;查询失败不能写成“成交额为零”。
- 检查报告与当前要求、证据一致,保存结果并提交完成状态,才进入
completed。生成到一半的文字只是草稿。
Run状态与操作状态要分开存。 Run说明整次分析走到哪里;操作记录说明某次查询、模型请求或导出实际发生了什么。运行中的网络连接、取消控制器留在执行者内存;磁盘保存标识和事实,读回记录并不会恢复原来的连接。
页面停止输出也不能代替完成状态。刷新或重连后,应按Run标识读取服务端状态与已接受结果;模型结束一轮输出后,程序仍可能继续执行工具。
4. 用户点停止,究竟停止了什么?
停止Run,需要程序阻止后续工作,并逐项取消或核对已经发出的操作;改一个状态字段不会让它们自动停下。
先把界面上的几个动作分清:
| 动作 | Run与Session怎样处理 |
|---|---|
| 停止本次任务 | 请求取消指定Run,收束后结束;Session保留消息和已有结果 |
| 打断并补充要求 | 停止旧方向的推进,在安全边界应用新要求;本例继续原Run,下一篇展开 |
| 暂停后继续 | 先处理在途操作、保存可继续的进展,之后恢复尚未终结的Run;没有恢复能力就不承诺暂停 |
| 关闭页面或断流 | 观察连接结束;后台继续还是请求取消,由产品约定,不能凭断流宣布Run已结束 |
不同框架对interrupt的用法可能不同,不要从方法名推断它一定保留原Run,更不要推断它撤销了已经执行的动作。
已经发出的模型和工具怎样处理?
| 操作 | 程序需要做什么 |
|---|---|
| 还没启动的调用、排队任务和重试 | 阻止启动,真正领取执行前再检查一次取消状态 |
| 已发出的模型请求 | 使用服务支持的取消能力;只关闭本地响应流,不能证明远端计算和计费已经停止 |
| 进程内异步工具或循环 | 传入取消信号,在等待点或循环中响应;外层函数退出,不保证它们都退出 |
| 本地命令与子进程 | 对这次Run拥有的进程发终止信号,并核实退出;不能只检查“信号已发出”,还要考虑子孙进程 |
| 远程查询、导出等任务 | 用远端任务ID请求取消或查询;本地HTTP超时不证明远端任务已结束 |
| 已完成的查询或外部写入 | 保存实际结果;停止不会撤销已发送通知、已保存文件或已提交事务,必要时另做补偿 |
取消信号就是执行层给下属操作的“请停止”通知,TypeScript里的AbortSignal是一种实现。调用链必须实际传递并处理这个信号;为每个Run分别管理,避免停止S1时误停S2。
把run-1的停止走完
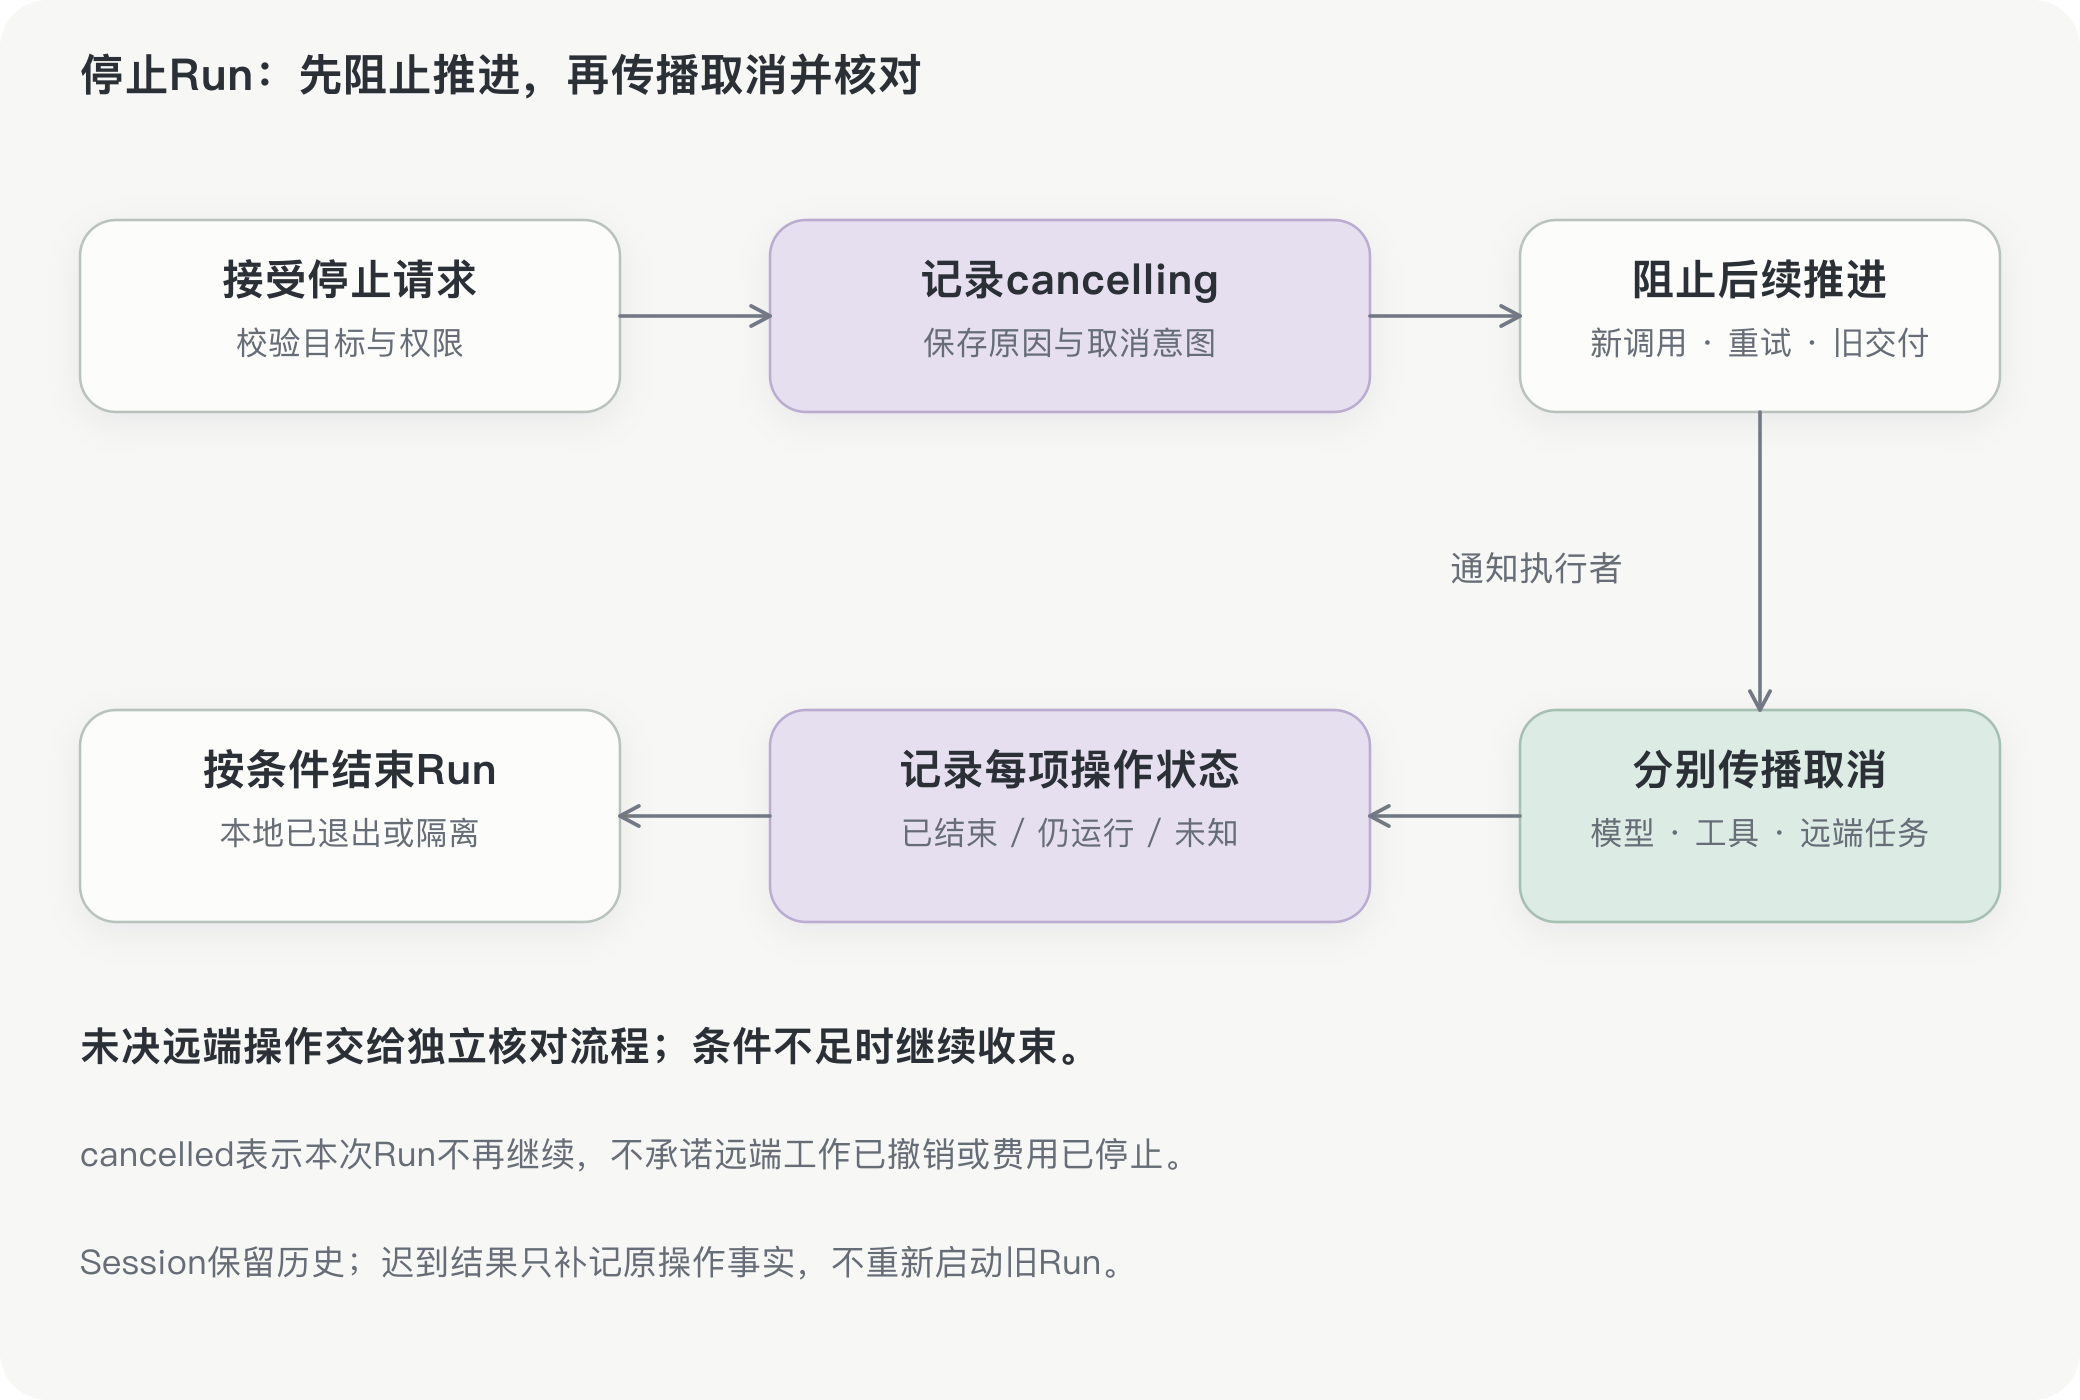
程序先把取消意图写入存储,进入cancelling,让执行者停止新轮次、新工具和重试,再向在途操作传播取消。逐项保存成功、失败、已取消或未知的事实;迟到结果可以补记原操作,不能让旧执行重新提交报告。
本地执行已退出或隔离,不能再推进和交付,远端未决事项也已登记并交给后续核对流程,才将本例Run记为cancelled。交接没有完成就继续收束。界面同时显示“远端导出待核对”等事项,不能把它们抹成“所有操作都已撤销”。
停止与完成可能同时到达,必须竞争同一个受控提交入口:报告先完成,就保留完成事实;取消先被接受,旧报告就不能再把Run提交成完成。
5. 没点停止,程序却报错或崩溃了怎么办?
单次调用失败可以重试;整次Run无法继续时,要保存已有事实、收束其他操作,再记录失败。
例如成交额已查到、流量查询失败。程序先判断能否在预算内重试或明确报告缺口;若必须结束,就停止后续调度,取消或核对仍在运行的其他操作,保存失败原因。一个并行工具抛异常,不保证其他工具自动取消;半份报告也不能作为最终交付。
如果执行进程直接崩溃,可能来不及清理,远端请求仍在运行,数据库里的running只是最后一次已知状态。需要由执行进程之外的调度或巡检逻辑:
- 发现失联后,将原Run置为待核对状态,例如
reconciling,并限制旧执行继续提交。一次心跳超时不证明它已经停止。 - 读取事先保存的操作和远端任务ID,查询成功、失败或未知;已经确认的结果照实保留,未知写操作不盲目重发。
- 按核对结果和恢复条件决定继续尚未终结的Run、记录失败,或结束原Run后创建关联的新Run。无法确认时保留待核对,不伪造一个确定结论。
具体的失联检测、取消控制、执行者接管和恢复进展怎样实现,在第07专题展开。这里先记住:Run的终态要有事实依据,不能靠清空内存或重置聊天记录得到。
6. Run结束后,这段对话还能继续吗?
可以。S1继续保留要求、补充、停止或失败原因、已确认操作与结果。某个Run失败,不代表Session也失败;清理时只释放这个Run拥有的执行资源,不能误清空后来启动的另一项任务。
用户再说“继续”,程序要说明是恢复尚未终结且有可用进展的Run,还是新建一次关联执行。已完成、失败或取消的Run不随意改回running,旧事实与旧报告保留。
新任务若依赖待确认的外部操作,或会修改同一份资源,先核对或隔离;其他不冲突的任务可按策略受理。归档、删除Session也不自动取消后台Run,需要停止时显式走取消流程。
可以用这段复盘检查四件事:消息和报告能否从S1存储读回;模型多次调用是否仍归run-1;停止后是否还在发起新操作;Run失败后,已有事实和Session是否仍可读取。
下一篇继续这段对话:运行中收到“只看新品”,怎样让新要求生效,并避免手机、电脑同时修改时互相覆盖。