00 · Agent开发学习路径
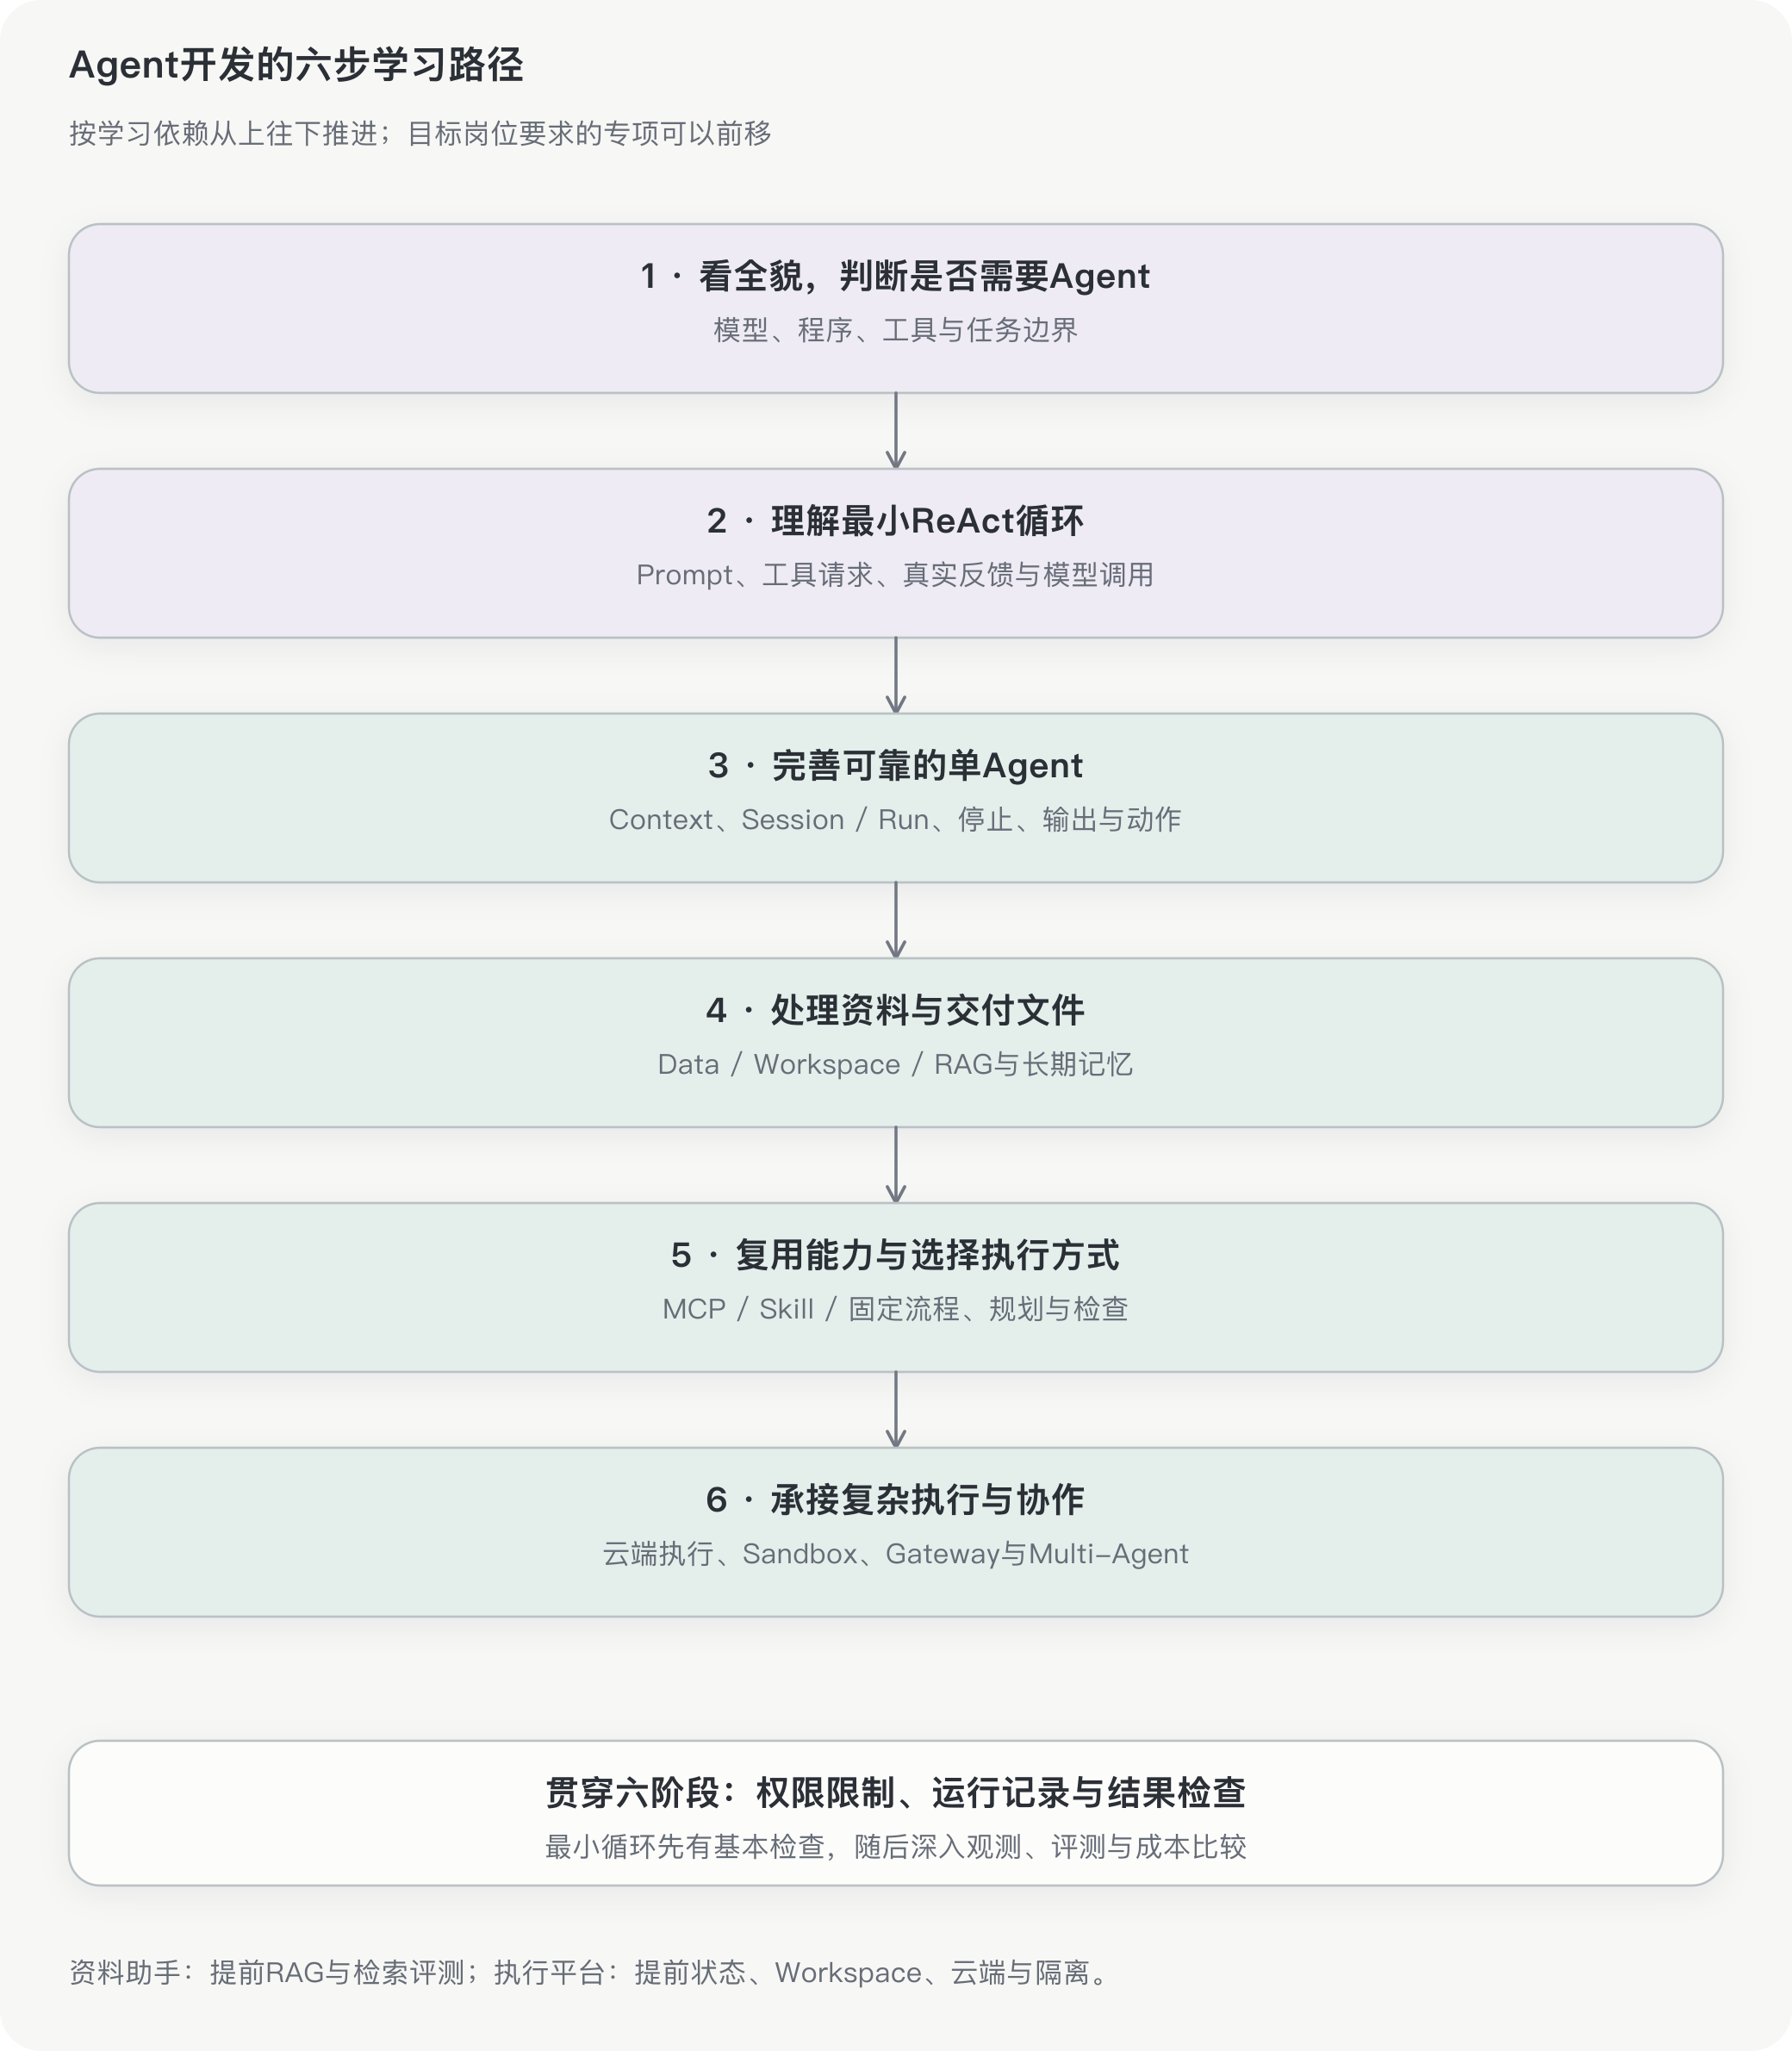
学习Agent开发,先看清全貌,再理解最小执行循环,随后沿着真实任务补齐输入、状态、资料、权限与交付。
内容同步:2026年10月28日 · 文档版本 5
学习Agent开发,先看清全貌,再理解最小执行循环,随后沿着真实任务补齐输入、状态、资料、权限与交付。
这条路线面向已有开发基础的程序员。接口、异步、存储和测试经验都用得上;新增的难点是,模型会根据已有信息选择下一步,程序必须把这些选择变成受控、可追溯的执行。
先用一个教学场景建立地图:用户要求“调查这次发布后错误率为什么升高,查监控和发布记录,给我一份有依据的报告,确认后再发送”。下面看这项任务怎样从一个简单循环,逐渐需要更多模块。具体机制进入对应专题学习。
第一阶段:先看全貌,判断是否需要Agent
Agent应用把模型判断和程序执行组织在一起。Harness是组织输入、模型、工具与状态的程序框架,Runtime强调它在运行时怎样推进和约束任务。先找到这几者的分工,再认识周围的模块。
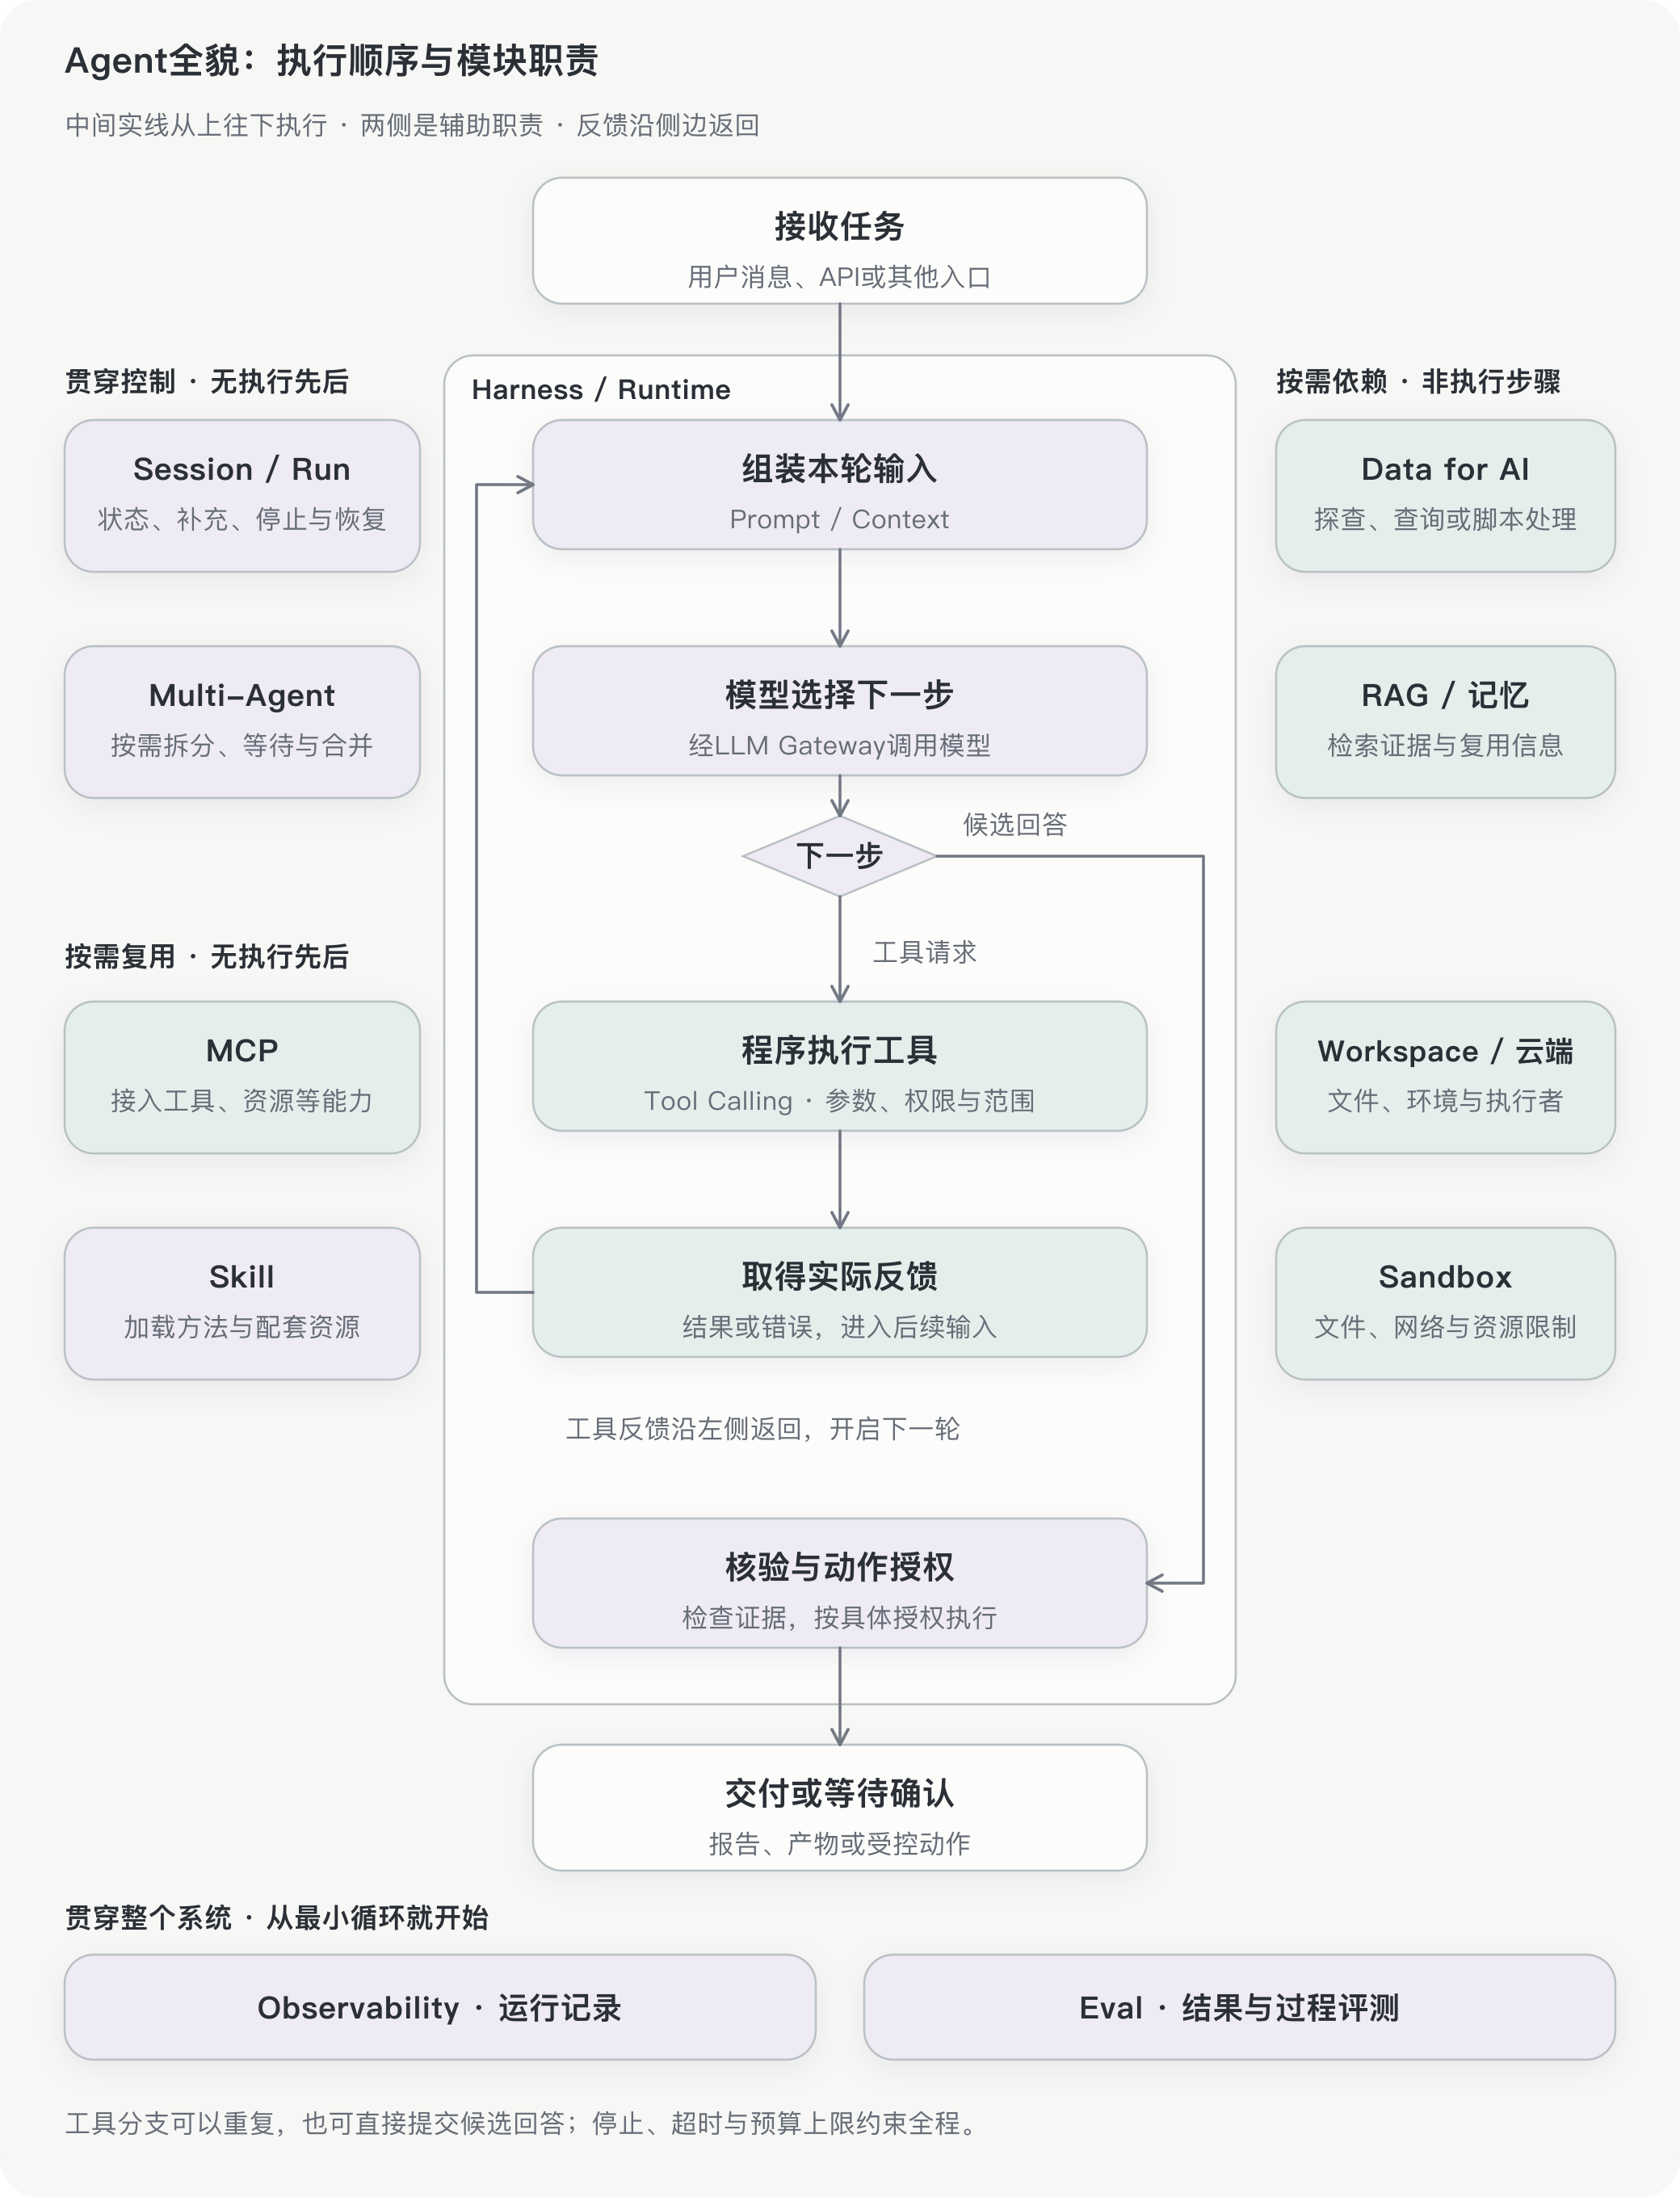
中间实线从上往下表示执行顺序。工具结果沿左侧回到下一轮输入,候选回答沿右侧进入核验与交付。两侧的状态、资料、文件和隔离能力按需参与,没有执行先后;这张图表示职责,不是服务部署拓扑。
如果调查永远是“查固定指标→填写固定报告”,业务工作流就足够。若查到错误集中在某类请求,才知道下一步该读哪些日志,可以让模型在获准能力内选择补查方向。固定步骤和动态选择也可以放进同一个系统。
这一阶段先能解释:模型判断什么,程序保证什么,这项任务为什么需要动态选择? 对应01 · Harness与执行模式,暂时不必掌握图里每个组件的实现。
第二阶段:理解一次最小ReAct循环
让Agent先只做少量只读操作:查指标、读发布记录、形成候选报告。Tool是程序开放的一项能力;模型给出工具名和参数,程序检查并执行,实际结果再进入下一次模型调用。
ReAct就是思考、行动、观察交替推进。 “思考”在这里指选择下一步,不要求展示模型内部思维文本。
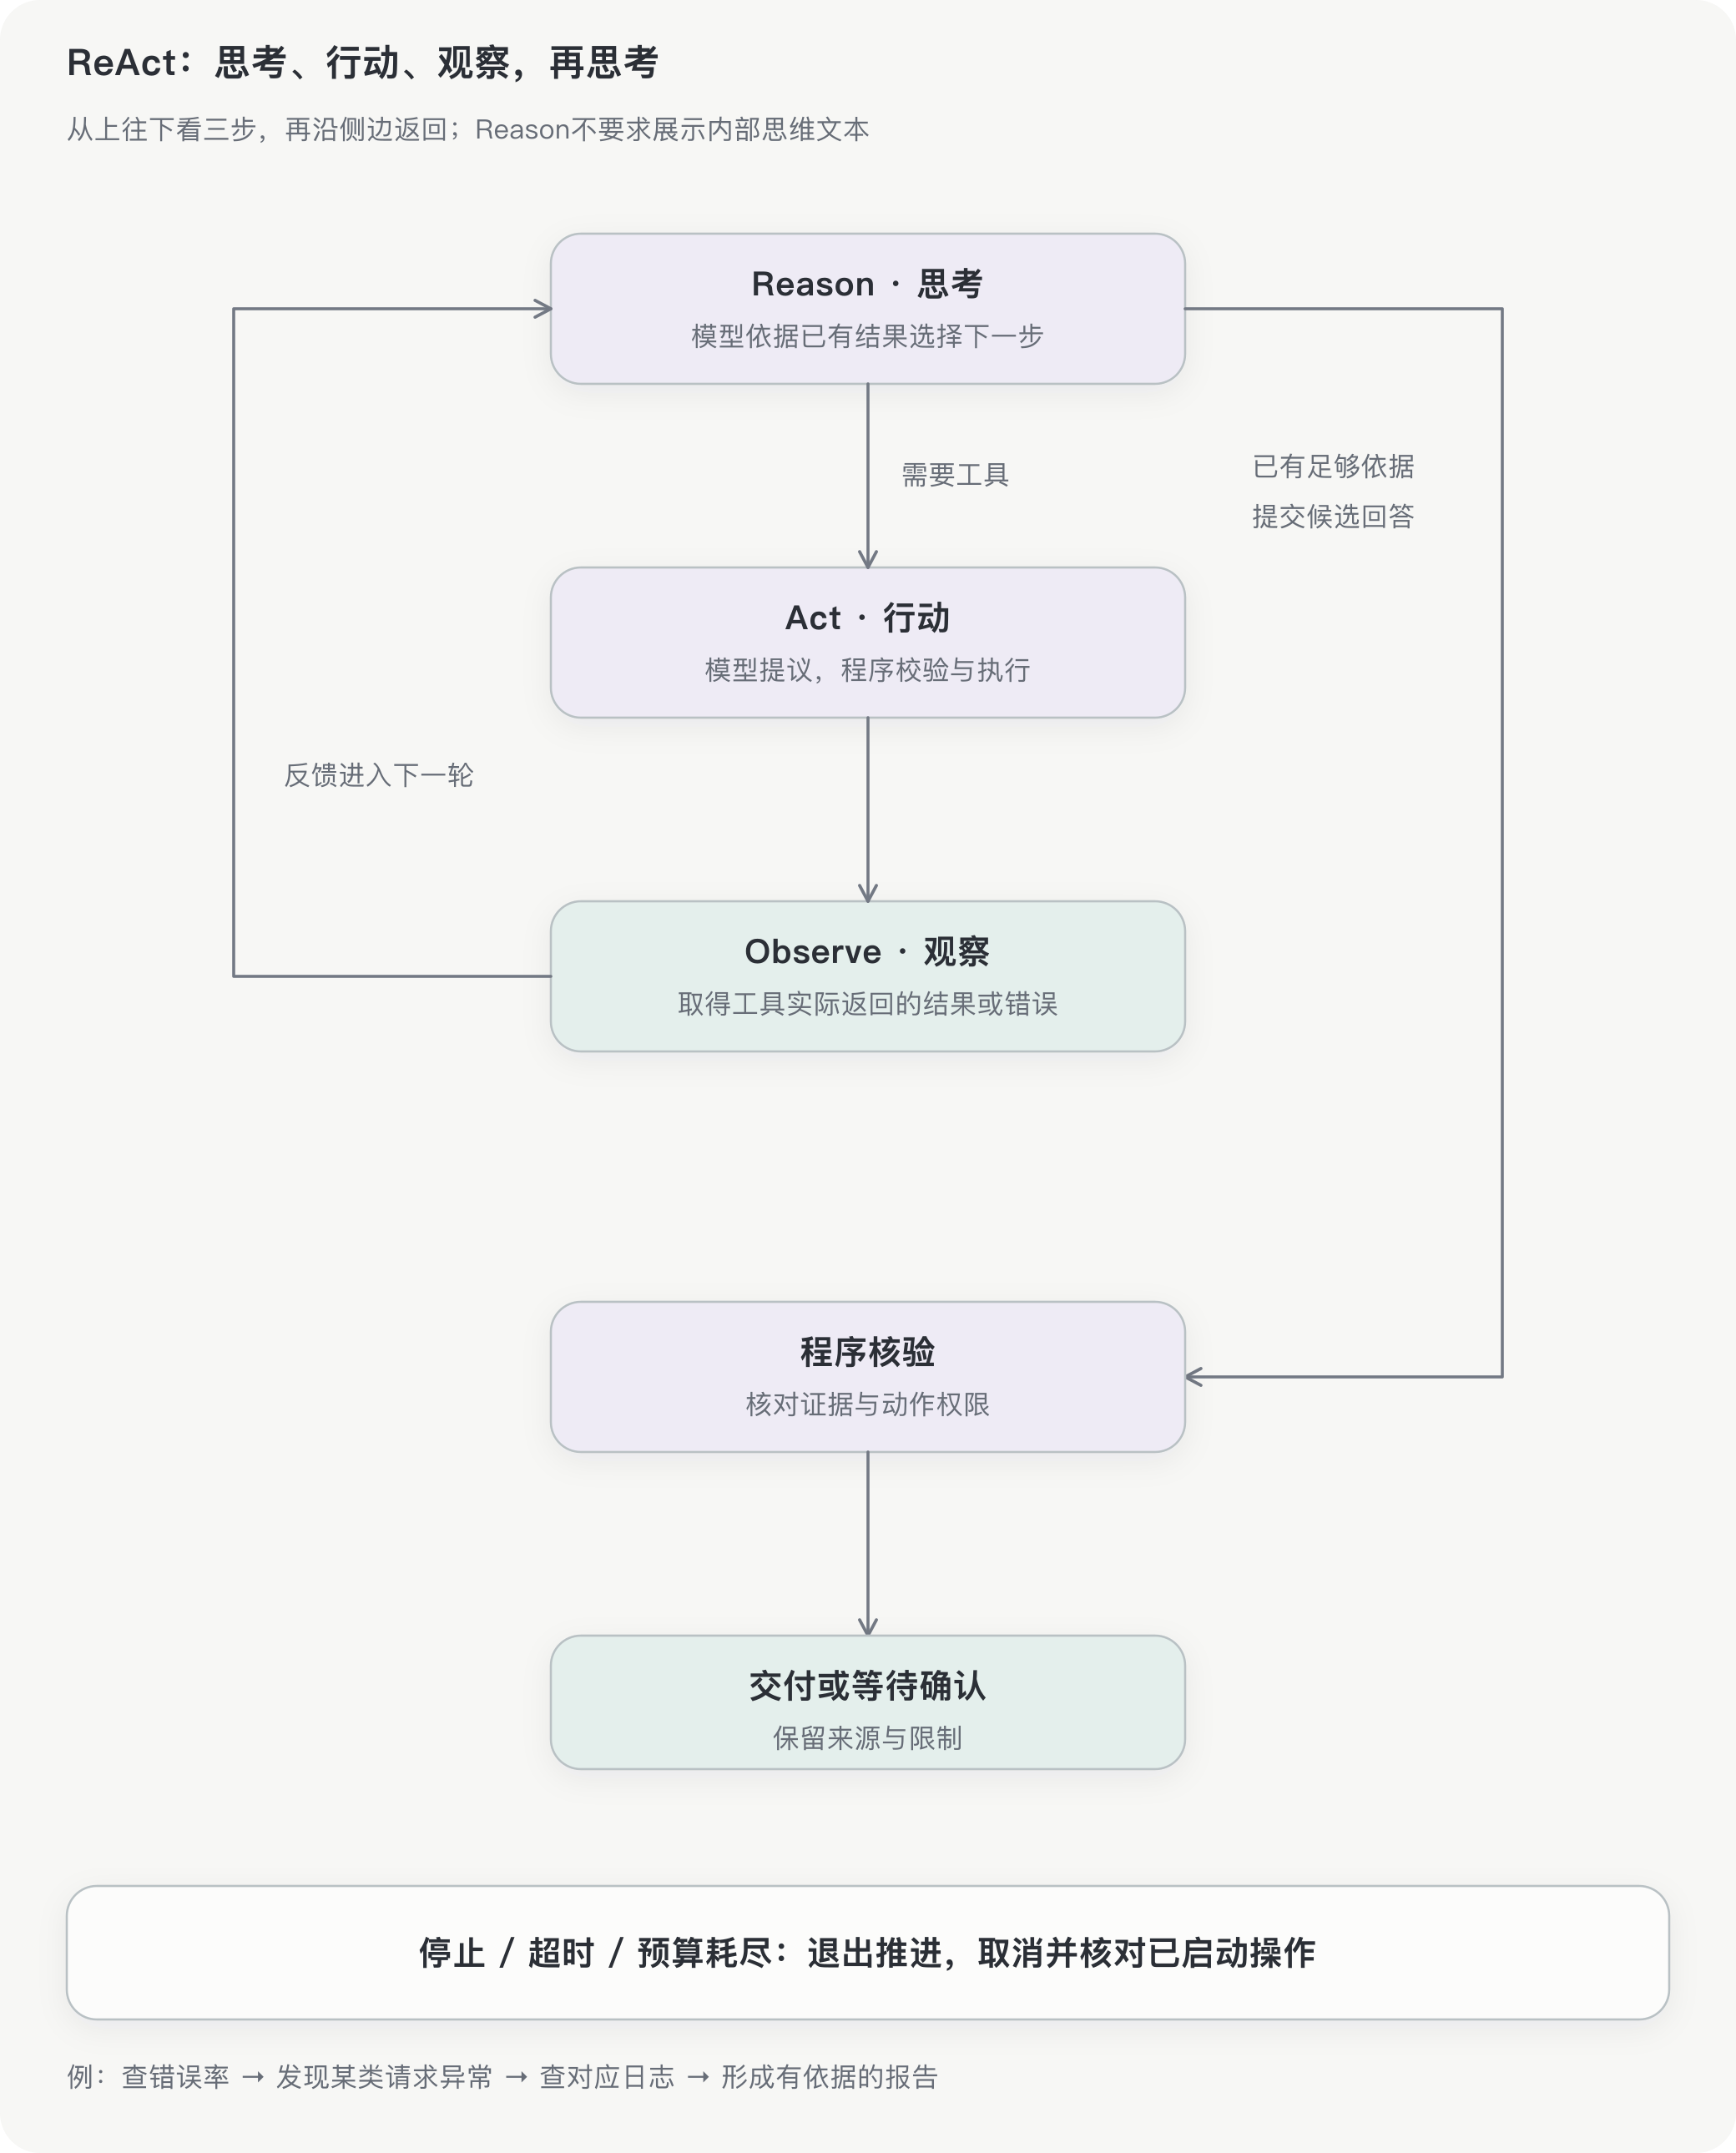
第一次查指标,发现异常集中在某类请求;第二次读取对应日志,再决定还要补什么证据。程序负责计算数字、限制范围,模型根据反馈选择方向。工具报错也是反馈,不能把失败当作查到“没有异常”。
先补模型调用的基本认识:token是内容计量单位,上下文窗口限制本次调用能容纳的信息;结构化输出帮助程序解析结果,流式响应逐步返回内容。能说明请求、响应和工具结果怎样衔接即可,再深入协议与适配。
此时就应限制轮数、时间和权限,保留调用记录,并用几项有明确判定标准的任务检查结果。后面再深入观测和评测。
学到能解释“模型请求为何还不能直接执行、反馈怎样改变下一步”,再读02 · Prompt、03 · Tool Calling。16 · 模型接入先看接口适配概念,限流与切换留待后面。
第三阶段:把单个Agent变成可靠的应用
调查开始持续多轮,历史里出现重复日志、旧猜测和用户新要求。用户又补充“只看移动端”,随后刷新页面或点击停止。这时问题进入上下文与任务生命周期。
Context决定每轮带哪些指令、历史和证据,类似为一次请求组织必要数据。Session保存持续对话,Run记录其中一次任务执行;它们需要明确的存储、归属和状态,不能依赖某个请求的内存。
“调查这次发布”可以开始run-1;运行中补充范围,修订当前执行;完成后要求“再按版本细分”,可以建立引用原结果的run-2。停止时,程序先阻止新增操作,再取消并核对已开始的模型、查询和脚本;界面停止输出不能证明远端工作已退出。
报告完成后还要检查数字和来源。发送等动作应核对具体授权、重复请求及结果未知的情况,这些与传统开发的状态机、事务、幂等和业务校验相通。
这一阶段要能走通“正常完成、补充要求、停止与恢复”三条路径。对应04 · Context、05.1 · Session/Run、05.2 · 补充与并发、05.3 · 停止与恢复、08 · 输出与动作。
第四阶段:处理真实资料,交付有归属的文件
资料开始散在监控API、日志文件、发布说明和表格中。人能从目录、表头和工作习惯里补出的含义,模型未必理解;把全部资料塞进输入,也会淹没关键证据。
先学Data for AI:识别结构、单位、时间范围和缺失,再选择处理方式。精确状态与数字适合查询;相关说明适合检索;批量文件可以由模型编写脚本,交给受控工具运行,再依据真实输出继续。计算与覆盖检查由程序完成。
接着学Workspace,它管理任务使用的文件与环境。例如输入快照、工作文件和报告分别保存,一次执行的报告可以放在 users/u1/sessions/s1/runs/r1/artifacts/report.md,下一次使用自己的目录。目录表达归属,实际访问仍要检查权限。
需要查文档时,再学RAG:先检索相关片段,再把证据交给模型。会话历史、文档知识与长期记忆分别管理;跨会话的报告偏好可以是结构化记录,不必全部转成向量检索。
学到能解释“这里为什么查数据库、那里为什么读文件,结果怎样追溯来源”,对应06 · Data for AI、07.1 · Workspace、11 · RAG与长期记忆。
第五阶段:复用能力,选择合适的执行方式
第二个业务系统也要接入同类工具,调查方法也要用于多个任务,这时再学习MCP和Skill。MCP统一外部工具、资源等能力的接入;Skill把方法说明和配套资源组织成可按需加载的单元。可以关联传统开发的适配器、插件与操作手册,但接入能力后仍需核对本次任务的使用权限。
同时回看执行模式:必须依次读取的资料可以固定成工作流;补查方向依赖反馈时用ReAct;步骤间依赖清楚时可以先规划;已有候选需要检查时可以加入自检与修订。它们可以组合,判断依据是任务特点与结果,而不是模式名字。
这一阶段要能解释“复用了什么、哪些步骤仍由程序控制、增加规划或检查付出什么代价”。对应09 · MCP、10 · Skill,以及01的执行模式比较。
第六阶段:承接长任务、动态执行与多Agent协作
任务需要离开页面继续运行,执行者可能失联,模型还可能生成脚本;只有明确的任务状态还不够,需要管理实际执行环境和资源。
| 能力 | 学习时抓住的问题 | 对应专题 |
|---|---|---|
| 云端执行 | 提交请求与执行完成怎样区分,断线或接管后怎样核对真实状态? | 07.2 |
| Sandbox | 动态脚本究竟能访问哪些文件、网络、凭据和资源? | 12 |
| LLM Gateway | 模型协议、流式输出、限流、预算和取消怎样统一管理? | 16 |
| Multi-Agent | 为什么拆分,哪些能并行,谁等待、合并并承担总预算? | 13 |
先把单Agent的输入输出和失败边界讲清楚,再考虑多执行者协作。只要开始运行模型生成的脚本,就应提前学习隔离;目标是执行平台岗位时,也应将Workspace、云端执行和资源管理前移。
观测与评测,从第二阶段就介入
Observability回答“这次发生了什么”,Eval回答“这项改动总体有没有变好”。最小循环先保留调用记录和少量可判定任务;模块增加后,再扩展等待、失败、成本和恢复等检查。
例如把“读取原文”改成“只读摘要”,需要同时看节省的调用和遗漏的证据。比较单Agent与多Agent,也要观察正确性、时延和资源消耗。不能凭一次回答更流畅就判断优化有效。
14 · 可观测性与15 · 评测保留独立深度课,并贯穿前面的学习阶段。
后端和数据库,需要补到什么程度?
沿用熟悉的Java、TypeScript、Python或Go等语言学习即可。先检查服务端权限、持久化、异步任务、并发更新、超时与幂等这些基础,再按目标团队补语言和框架。
数据库先选PostgreSQL或MySQL之一,掌握SQL增删改查、关联与分页、表关系和唯一约束;会为常见查询选择索引、查看执行计划;理解事务和条件更新,避免两名执行者同时接管一个Run;知道连接池、查询超时、迁移和备份恢复的作用。存储引擎源码、分库分表等内容按岗位和规模继续深入。
组件跟着问题引入:
| 组件 | 引入它要解决什么 |
|---|---|
| 关系数据库 | 可靠保存Session、Run、消息和操作状态,检查归属与并发 |
| 任务队列 | 将长任务交给独立执行者,处理调度、重试与接管;初期可以简化实现 |
| 对象存储 | 多执行者之间保存附件和产物;单机少量文件可先用受控目录 |
| Redis | 有明确的短期缓存、共享限流或协调需求;持久任务记录仍要可靠保存 |
| 向量检索 | 按语义寻找相关片段;精确事实继续使用查询,也可在已有数据库中接入向量能力 |
| 容器与隔离环境 | 部署执行者、限制资源或运行动态脚本;还需落实文件、网络与凭据边界 |
前端开发者,重点补哪几项?
TypeScript、异步请求、接口契约和交互经验可以继续用,重点补页面之外的责任:
- 页面刷新、断线和取消加载以后,Run怎样保存、继续或停止;补后台任务、持久化和取消传播。
- 隐藏按钮与浏览器缓存解决不了服务端授权和可靠存储;补上述数据库深度、资源归属与密钥管理。
- 在熟悉语言上补服务端开发,理解进程、日志、网络和资源限制,能够从界面状态追到实际执行端。
按目标岗位调整深入顺序
共同基础优先,专项深度跟着目标JD调整;后学不代表岗位不重视。
| 目标方向 | 优先深入 |
|---|---|
| Agent应用与全栈产品 | 工具、上下文、状态、输出校验,再看业务需要的接入与复用 |
| 知识库与资料助手 | 提前Data、RAG、权限过滤和检索评测 |
| Harness/Runtime执行平台 | 提前Session/Run、Workspace、云端、隔离、Gateway与恢复 |
| 多Agent与复杂编排 | 先掌握单Agent与任务拆分,再深入共享边界、合并、预算和评测 |
每到一个专题,先看开头的全景定位图:骨架保持不变,加深的区域就是本课组件。再把同一套问题迁移到代码修改、资料审阅或数据分析,检查自己能否指出输入、状态、工具、执行环境和交付分别由谁负责。
从01 · Harness入门继续;需要按模块查阅时使用全套目录或组件定位图册。